Les deux languesChaque article existe en français et en anglais. Le titre mène à la version française, [ EN ] à l’anglaise.

Écrits

Revues d’articles et tutoriels, 3 à ce jour. Les revues expliquent le problème qu’un article voulait résoudre, son idée centrale et la construction du réseau ; les tutoriels avancent pas à pas, avec tout le code, de l’installation jusqu’au résultat final.

FaibleFort

Attention(Q, K, V) = softmax(QKTdk) V

[attention, Vaswani et al. 2017, Attention Is All You Need]

Huit termes qui couvrent l’essentiel de mon travail. Chaque case montre à quel point deux d’entre eux sont liés dans mes projets. Le Deep Learning est au centre, relié à Computer Vision, NLP et Speech Processing, et ces deux derniers sont étroitement liés par mon travail sur le mooré. Data Engineering reste proche de Data Science et de MLOps. La grille est symétrique, ce qu’une vraie carte d’attention n’est presque jamais : lisez-la comme un portrait des idées qui vont ensemble, pas comme les poids d’un modèle entraîné.

Revues d’articles
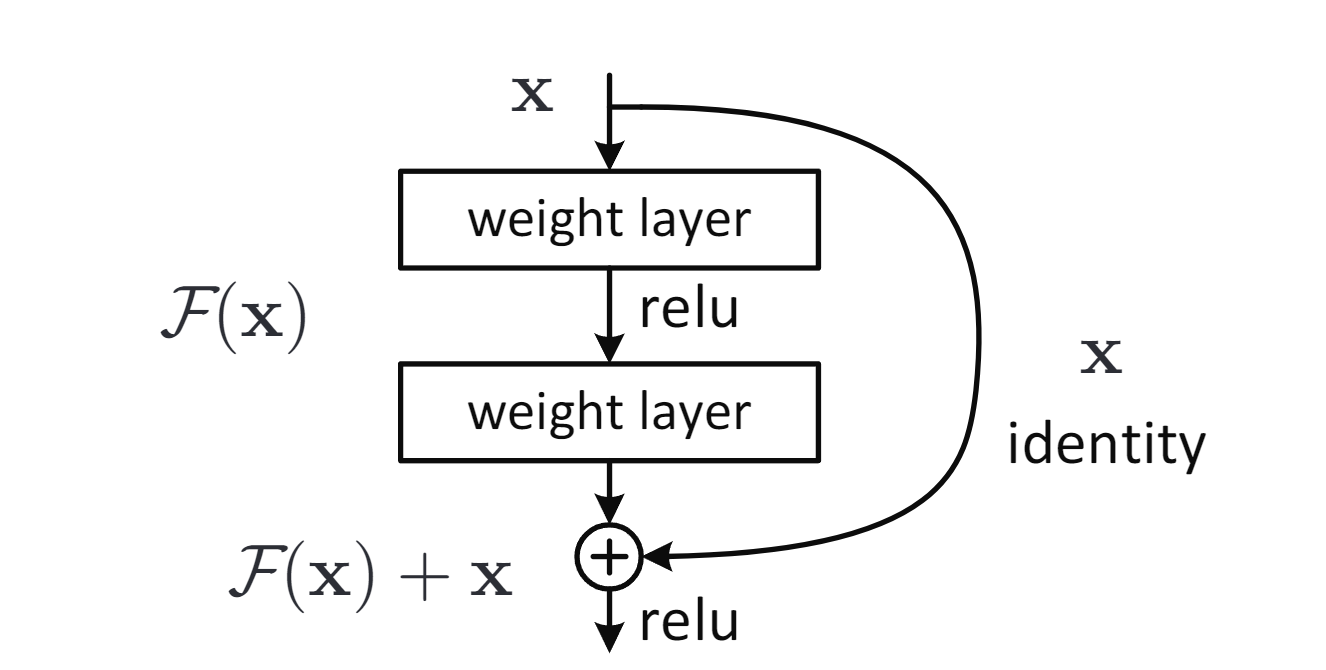
Connexion résiduelle, bloc ResNet.Mots-cléspaper review · deep learning · cnn · resnet

ResNet, apprentissage résiduel profond pour la reconnaissance d'images

EN FR · 5 min de lecture
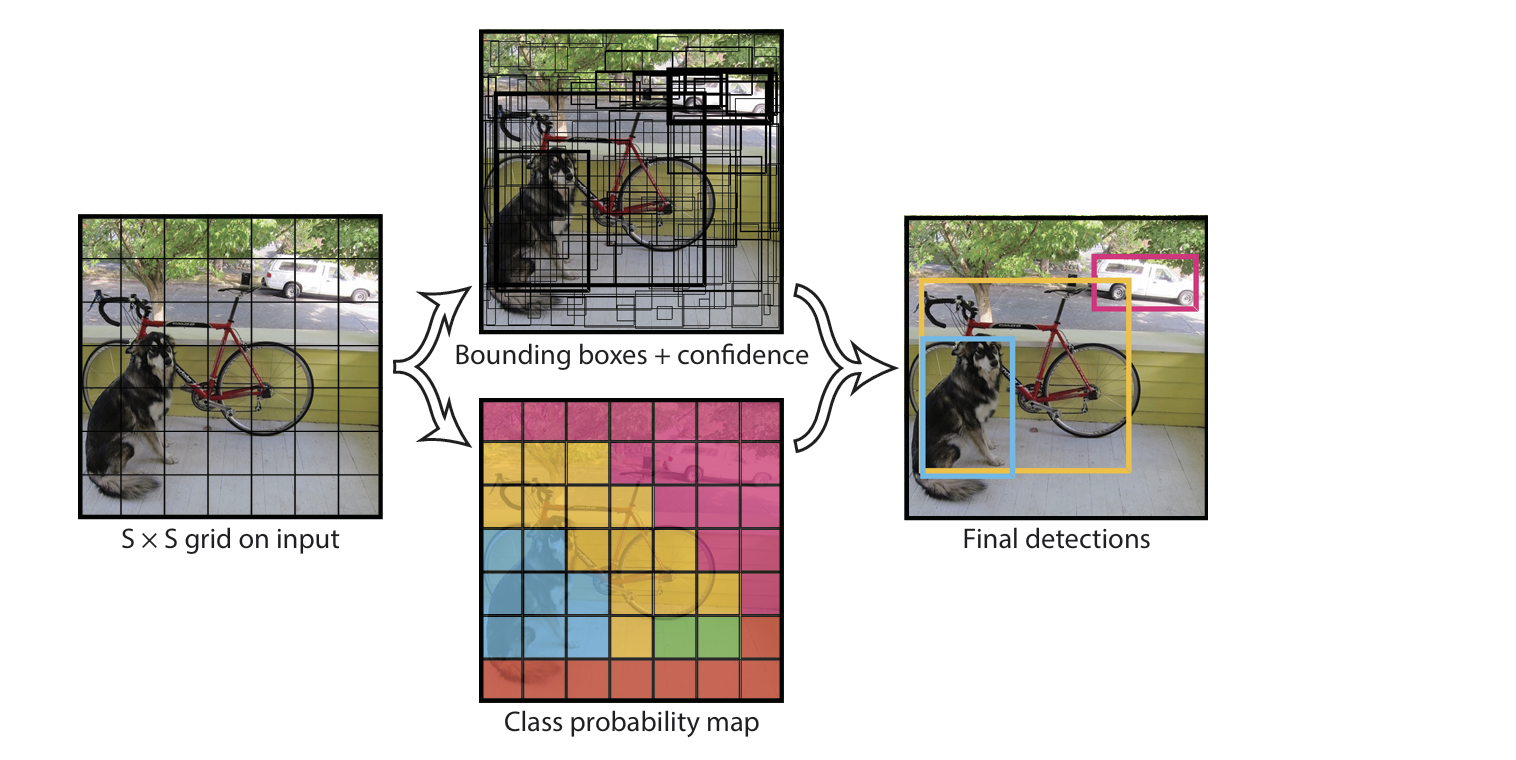
Modèle YOLO.Mots-cléspaper review · deep learning · cnn · yolo

YOLO, You Only Look Once

EN FR · 4 min de lecture

Tutoriels

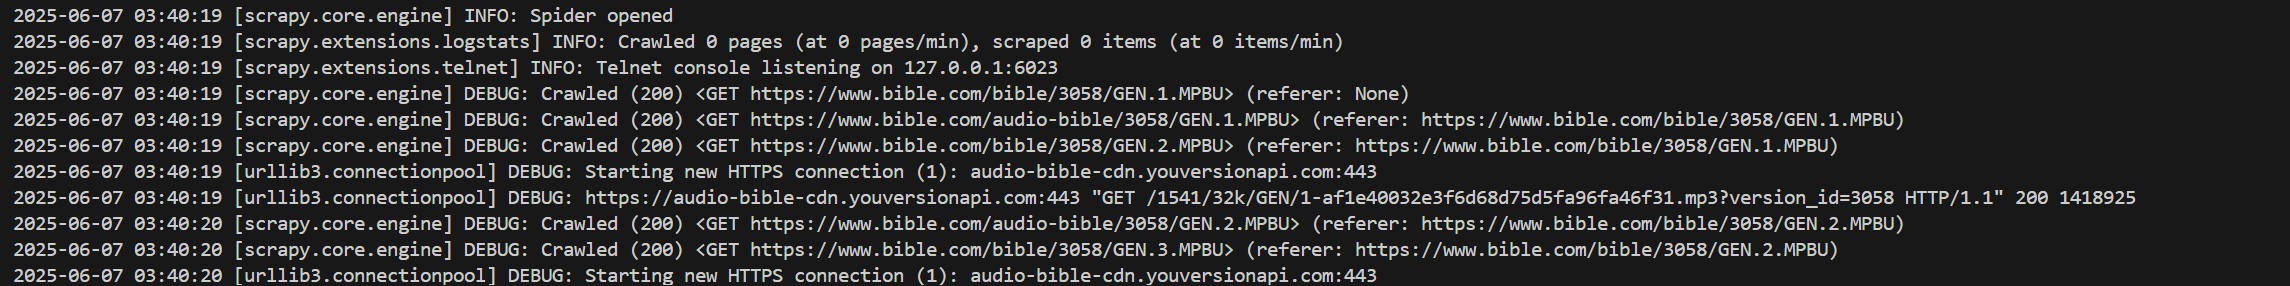
Processus de crawlMots-clésmoore · speech recognition · huggingface · tts · asr

MooreSpeechCorpora Toolkit, Collecte de données Mooré à partir de la Bible

EN FR · 4 min de lecture

Colophon

Pourquoi ces huitQuelques formules fondatrices qui font tourner l’apprentissage profond moderne, et que je trouve sincèrement belles.

Huit équations, du neurone seul aux modèles génératifs.

y = φ(∑i wixi + b)

Le neurone seul · Rosenblatt, 1958 · dessiné sur la page Travaux

f(x) = f(3)(f(2)(f(1)(x)))

Réseaux profonds à propagation avant · Goodfellow et al., 2016 · dessiné sur la page d’accueil

θ* = arg maxθi log pθ(xi)

Maximum de vraisemblance · d’après Fisher, 1922

ℒ = − ∑i yi log ŷi

Entropie croisée · d’après Shannon, 1948 · Classification de signaux radio

θθηθℒ(θ)

Descente de gradient · Cauchy, 1847

y = ℱ(x, {Wi}) + x

Bloc résiduel · He et al., 2015 · ResNet, la revue

Attention(Q, K, V) = softmax(QK / √dk) V

Attention par produit scalaire normalisé · Vaswani et al., 2017 · Florence-2 et les VLM

minθ maxφ 𝔼xpdata[log Dφ(x)] +
𝔼zpz[log(1 − Dφ(Gθ(z)))]

Réseaux antagonistes génératifs · Goodfellow et al., 2014 · DCGAN sur MNIST

Retour à l’accueil →